

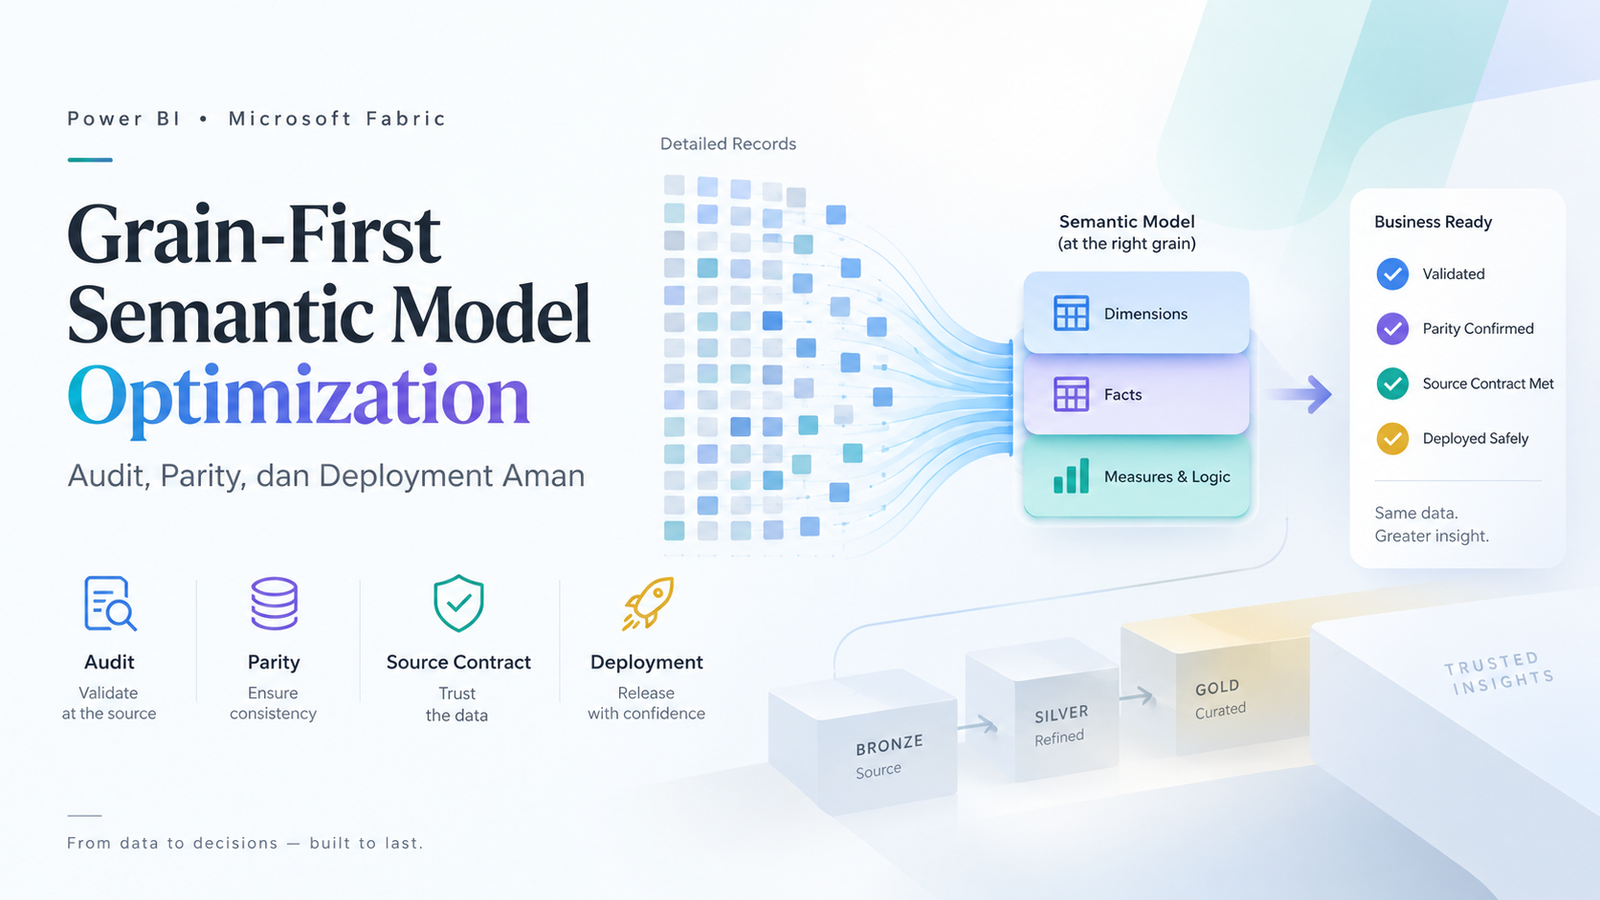
Optimasi semantic model Power BI di Microsoft Fabric bukan sekadar menghapus kolom atau mengecilkan ukuran model. Pada model yang kompleks, target utamanya adalah mengurangi beban fisik tanpa mengubah makna bisnis.
Panduan ini membahas pola grain-first semantic optimization yang dapat digunakan secara umum pada model Import di Power BI dan Microsoft Fabric, dengan contoh generik untuk menjelaskan prinsip desain, validasi, dan deployment.
1. Mulai dari Baseline yang Tidak Berubah
Sebelum melakukan optimasi, buat baseline yang dapat diaudit. Tujuannya adalah mengetahui secara tepat apa yang dianggap “benar” sebelum model diubah.
Baseline biasanya mencakup:
- jumlah tabel, kolom, measure, relationship, dan partition;
- ukuran VertiPaq per tabel dan per kolom;
- formula penting;
- relationship path;
- report-bound fields dan measures;
- hasil KPI pada beberapa filter representatif;
- source contract setiap partition.
Untuk investigasi awal, metadata sebaiknya dibaca dalam mode read-only. Perubahan baru dilakukan setelah bukti cukup kuat.
with connect_semantic_model(
    dataset=semantic_model_id,
    workspace=workspace_id,
    readonly=True
) as tom:
    model = tom.model
    # inspect shape, partitions, measures, relationships
2. Bedakan Logical Grain dan Physical Grain
Salah satu sumber pemborosan terbesar pada semantic model adalah fact table yang disimpan pada grain jauh lebih detail daripada yang sebenarnya dibutuhkan oleh measure analitik. Prinsip ini sejalan dengan panduan resmi Microsoft tentang star schema dan consistent fact grain, serta data reduction untuk Import models.
Logical grain adalah kombinasi business key yang menentukan arti satu record dari sudut pandang analitik. Physical grain adalah bagaimana baris benar-benar disimpan di fact table.
Keduanya tidak selalu harus identik. Jika banyak record detail hanya berbeda pada atribut yang tidak digunakan oleh measure atau visual, fact dapat direpresentasikan pada grain yang lebih ringkas selama business semantics tetap ekuivalen.
3. Ilustrasi Grain Reduction: Puluhan Juta Baris Menjadi Beberapa Juta Baris Analitik
Bayangkan sebuah FactTransaction berisi sekitar 30 juta transaction rows. Setelah dependency analysis, report utama ternyata hanya membutuhkan kombinasi:
EntityKeyTransactionDateTransactionTypeActivityRuleKeyItemGroupKey- dua additive measures
Jika banyak transaction rows memiliki kombinasi key yang sama, baris tersebut dapat digabungkan menjadi satu business-measure record. Sebagai contoh, 30 juta transaction rows dapat direpresentasikan menjadi sekitar 8 juta analytic rows ketika grain equivalence dan additive behavior sudah terbukti.
Besarnya pengurangan akan berbeda pada setiap model. Fokus utamanya tetap pada pembuktian grain equivalence dan konsistensi hasil bisnis, bukan pada target row reduction tertentu.
Raw transaction grain
        ↓
map stable business keys
        ↓
compress repeated classifications
        ↓
preserve orphan identity
        ↓
GROUP BY business-measure grain
        ↓
SUM additive measures
        ↓
re-expand only report-facing attributes
Analytic fact grain
4. Gunakan Surrogate Key untuk Atribut yang Berulang
Atribut klasifikasi yang berulang biasanya mahal jika terus disimpan sebagai teks di fact table. Pola yang lebih efisien adalah membuat rule dimension dan mengganti sekumpulan atribut dengan integer surrogate key.
Contoh generik:
ActivityCategory
ActivitySubCategory
ActivityClass
ReportingClass
ApplicationType
        ↓
ActivityRuleKey
Hal yang sama dapat dilakukan pada klasifikasi item, entity, lokasi, atau aturan bisnis lain selama mapping-nya deterministik.
Manfaatnya bukan hanya mengurangi jumlah kolom teks. Integer key juga cenderung lebih ramah terhadap dictionary encoding, relationship, dan grouping.
5. Jangan Menggabungkan Orphan secara Tidak Sengaja
Salah satu risiko saat mengganti business identifier dengan surrogate key adalah record yang belum memiliki pasangan dimension.
Jika semua unmatched records diberi key yang sama, misalnya 0, dua business entity berbeda dapat ikut tergabung ketika fact di-aggregate.
Pola yang lebih aman adalah:
- gunakan surrogate key untuk record yang berhasil dipetakan;
- gunakan special key untuk menandai unmatched record;
- pertahankan original business identifier sebagai temporary grouping guard;
- hapus guard tersebut dari output setelah grouping selesai jika report memang tidak membutuhkannya.
Dengan demikian, optimasi tetap mendapat manfaat surrogate key tanpa mengorbankan pemisahan record orphan.
6. Aggregation Hanya Aman untuk Measure yang Sesuai
Fact-grain reduction paling cocok untuk measure yang benar-benar additive pada grain baru, seperti:
SUM(Amount)SUM(Quantity)SUM(Duration)
Sebaliknya, measure yang bergantung pada row identity, urutan event, distinct transaction, atau detail ticket harus dianalisis secara terpisah.
Karena itu sebelum mengubah grain, lakukan dependency scan terhadap retained measures dan report bindings. Jika report masih membutuhkan detail-level behavior, pisahkan:
Analytic metric service
    → compact Import fact

Detail / drill-through service
    → narrow detail route
Dengan pemisahan tersebut, query agregat tidak perlu membawa seluruh row-level history ke memory, sementara kebutuhan detail tetap tersedia melalui jalur khusus.
7. Business Parity Lebih Penting daripada Row Count
Setelah fact diubah grain-nya, COUNTROWS() memang akan berbeda. Itu bukan otomatis kegagalan.
Yang harus tetap parity adalah hasil bisnis yang memang dijanjikan semantic layer, misalnya:
- total additive measures;
- rasio atau KPI turunan;
- breakdown per dimension;
- filter behavior;
- drill path yang dipertahankan;
- report-bound measures.
Karena itu acceptance test harus membandingkan output semantic, bukan memaksa jumlah physical rows tetap sama.
8. Source Contract adalah Bagian dari Semantic Contract
Dua semantic model dapat memiliki nama tabel dan formula yang sama tetapi tetap menghasilkan angka berbeda jika physical source-nya berbeda.
Audit source contract setidaknya perlu memeriksa:
| Komponen | Apa yang diverifikasi |
|---|---|
| Endpoint | Sumber data yang benar |
| Database | Database yang benar-benar dibaca |
| Schema | Schema fisik setiap object |
| Physical object | Table atau view yang digunakan |
| Native SQL | FROM dan JOIN di dalam NativeQuery |
Ini penting terutama jika model menggunakan parameter database bersama. Tidak semua partition harus selalu mengikuti satu database global.
9. Gunakan Split Database Routing jika Source Memang Terpisah
Pada arsitektur tertentu, fact dan dimension utama dapat berasal dari satu database, sedangkan tabel auxiliary tetap berada pada database lain.
Dalam kondisi tersebut, lebih aman membuat routing eksplisit:
Core semantic path
    → primary analytical database
    → domain schema

Auxiliary / pass-through path
    → secondary database
    → existing schema
Tujuannya bukan memperbanyak parameter, melainkan memastikan setiap partition membaca physical source yang memang menjadi kontraknya.
10. Guarded Apply: Satu Mutation, Lalu Verifikasi
Metadata optimization sebaiknya tidak dieksekusi sebagai rangkaian trial-and-error langsung di model utama. Pola yang lebih aman adalah:
- read-only discovery;
- capture immutable baseline;
- build candidate change in-memory;
- tampilkan diff;
- recheck state tepat sebelum write;
- lakukan satu metadata commit;
- buka kembali secara read-only;
- verify shape, formulas, relationships, dan source expressions.
Refresh sebaiknya menjadi checkpoint terpisah. Ini menghindari pola ubah → refresh → salah → ubah lagi → refresh lagi yang mahal dan sulit diaudit. Untuk model berpartisi, Microsoft juga menyediakan Enhanced Refresh REST API yang mendukung refresh pada level table atau partition, commit mode, timeout, dan monitoring request.
11. Refresh Sekali Setelah Desain Sudah Stabil
Setelah seluruh metadata guard lolos, barulah lakukan satu controlled refresh pada candidate.
Refresh dianggap sukses hanya jika:
- semua partition yang diperlukan berhasil diproses;
- model dapat di-query;
- business parity lulus;
- report smoke test lulus;
- tidak muncul missing-field atau relationship regression baru;
- ukuran dan runtime behavior diukur kembali.
12. Pisahkan Storage Transition dari Semantic Redesign
Jika semantic model perlu dipindahkan, diekspor, atau dikonversi ke storage format lain, lakukan setelah business parity tercapai. Power BI REST API mendokumentasikan properti targetStorageMode dan mendukung perubahan ke PremiumFiles untuk large semantic model storage format maupun kembali ke Abf untuk small semantic model storage format melalui Update Dataset In Group.
Perubahan storage mode tidak boleh dianggap sebagai jaminan bahwa file PBIX otomatis dapat diunduh. Microsoft mendokumentasikan batasan download secara terpisah—misalnya untuk incremental refresh, Direct Lake, ukuran model, dan large semantic model storage format—pada panduan Download a report or semantic model as PBIX. Karena itu, setelah storage transition, validasi tetap perlu mencakup kesiapan backend dan ketersediaan download pada Power BI service.
Untuk workflow XMLA, Microsoft justru merekomendasikan large semantic model storage format untuk meningkatkan performa operasi write melalui XMLA endpoint. Dokumentasi XMLA juga mencatat bahwa operasi write tertentu pada semantic model yang berasal dari Power BI Desktop dapat memengaruhi kemampuan download kembali sebagai PBIX. Lihat Semantic model connectivity and management with the XMLA endpoint dan Large semantic models in Power BI Premium.
Pola verifikasi yang baik adalah:
- control plane menunjukkan target storage state;
- metadata interface dapat dibuka kembali;
- DAX query sederhana berhasil;
- business parity query tetap sama;
- partition definition dan formula hash tetap tidak berubah.
13. Workflow Reusable
Rangkaian ini dapat diringkas menjadi:
discover
→ audit
→ define logical grain
→ prove equivalence
→ build candidate
→ guarded apply
→ refresh once
→ business parity
→ measure actual impact
→ promote
Urutan tersebut sengaja menempatkan business correctness sebelum compression target.
14. Checklist Sebelum Production
- Apakah logical grain setiap fact sudah didefinisikan?
- Apakah surrogate key mempunyai mapping deterministik?
- Apakah orphan records tetap terpisah secara bisnis?
- Apakah semua retained measures aman terhadap grain baru?
- Apakah detail-level report memiliki jalur sendiri bila masih diperlukan?
- Apakah source database, schema, dan physical object sudah diverifikasi?
- Apakah NativeQuery sudah diaudit?
- Apakah candidate diproses hanya setelah metadata stabil?
- Apakah business parity diuji pada beberapa filter representatif?
- Apakah storage transition diverifikasi sampai backend queryable?
- Apakah production tetap menjadi baseline sampai candidate lulus seluruh gate?
Kesimpulan
Optimasi semantic model yang efektif bukan perlombaan menghapus sebanyak mungkin kolom atau mengejar persentase pengurangan tertentu. Pendekatan yang lebih kuat adalah menentukan grain yang benar, memisahkan detail dan analytic service bila diperlukan, menggunakan surrogate key secara aman, menjaga source contract, dan membuktikan parity sebelum promotion.
Dengan pendekatan grain-first, model dapat menjadi jauh lebih ringkas tanpa menjadikan ukuran model sebagai satu-satunya indikator keberhasilan. Ukuran, refresh cost, dan query performance tetap penting, tetapi semuanya harus berada setelah semantic correctness.
Referensi Resmi Microsoft
- Understand star schema and the importance for Power BI
- Data reduction techniques for Import modeling
- Enhanced refresh with the Power BI REST API
- Power BI REST API — Update Dataset In Group
- XMLA endpoint connectivity and management
- Download reports and semantic models as PBIX
- Fabric REST API — Get Semantic Model Definition (TMDL/TMSL)
Resource Terkait
- Semantic Model Engineering untuk Power BI dan Microsoft Fabric — hub engineering untuk source, model, refresh, observability, dan validation.
- Orkestrasi Refresh Semantic Model Power BI dengan Semantic Link (SemPy) — targeted refresh, partition lifecycle, dan execution evidence.
- Power BI Services Indonesia — konteks layanan implementasi dan engineering Power BI.